Защищённая диссертация в России живёт странной жизнью. Обязательный экземпляр лежит в Российской государственной библиотеке, PDF, выложенный к защите, остаётся на сайте диссертационного совета, автореферат расходится по базам, а платные сайты торгуют текстом целиком и по главам, как правило, без ведома автора. Найти текст можно: на вопрос «где диссертация такого-то» ИИ-ассистент сегодня приводит ссылку на PDF совета или на витрину платного агрегатора. Выход, который я выбрала для своей работы, называется просто: диссертация в открытом репозитории.
Здесь стоит различать два случая. Если диссертация защищалась недавно, текст, как правило, где-то существует, и проблема автора не в том, что текста нет, а в том, как он существует. Файл на сайте совета живёт, пока живёт сайт, и автор им не управляет. Сослаться внутри 468-страничного PDF на конкретную главу негде: ссылка ведёт на весь файл, а читатель ищет нужную страницу сам. Готовой библиографической записи с постоянным идентификатором у файла нет, и каждый, кто цитирует, собирает её самостоятельно, нередко с ошибками в месте и годе. Для платного агрегатора текст и вовсе товар, а не научный результат.
Если же диссертация защищалась давно, дело обычно хуже. Выкладывать полный текст на сайт организации до защиты обязали далеко не сразу, а только постановлением правительства 2013 года, и у работ более раннего возраста цифрового следа часто нет вовсе: ни PDF совета, ни свободного автореферата, только платная карточка в одной из коммерческих баз перепродажи диссертаций. Для такой работы открытый репозиторий не улучшает форму существующего текста, а буквально впервые выводит его в общее цифровое поле, откуда иначе его не достать никому, даже автору.
Наглядный случай — докторская диссертация 1999 года моего научного руководителя, Тамары Григорьевны Калачёвой, о научной школе которой я писала в статье об уроках её школы. Здесь есть и дополнительное ограничение: правопреемники не дали согласия на публикацию полного текста, а переработка сама по себе прав не снимает, поэтому открытого репозитория с оригинальным текстом нет и в обозримом будущем не будет. Но задачу это не отменяет, а сужает: в открытом доступе выложена аналитическая версия работы с разбором её ключевых идей и методологии, github.com/inna-gazieva/kalacheva-professionalizm-analiz, с DOI и ссылкой на упомянутую статью о её научной школе. Это не замена оригиналу и не выход из-под ограничения, а способ дать читателю и ИИ-ассистенту адрес, структуру и научный контекст там, где раньше не было вообще ничего.
Похожая картина и у других её учеников, но без правового ограничения. Одна из кандидатских её школы по социологии, защищённая в Волго-Вятской академии государственной службы в 2006 году, в сети существует только как автореферат: полный текст можно прочитать в библиотеке академии или купить у коммерческого агрегатора, свободно в интернете его нет. Никакого запрета здесь нет, просто работа защищалась в 2006 году, когда обязанности выкладывать текст в сеть ещё не существовало, и с тех пор в сеть её никто не выкладывал. Вот для такой диссертации открытый репозиторий и был бы прямым решением: закон его не требует, но и не запрещает, а сделать это, кроме самого автора, некому.
Задача автора здесь одна: дать своей работе адрес, структуру и реквизиты, которыми управляет он сам, и сделать доступ к ней максимально лёгким, а для давних работ без цифрового следа — создать этот доступ впервые.
Вопрос обострился за последние два года, потому что изменился читатель. Аспирант, который ищет методику измерения ценностей, всё чаще спрашивает не поисковую систему, а ИИ-ассистента, и тот отвечает по тем текстам, которые способен прочитать: диссертация в библиотеке для него недоступна, большой PDF он читает медленно и ссылается на страницы внутри одного файла, а текст по главам в открытом репозитории даёт ему адрес каждого раздела и готовую запись для цитирования. Однако между «выложить файл» и «сделать текст по-настоящему открытым» лежит немалая работа.
Что такое диссертация в открытом репозитории и как её оформить? По сути, это значит превратить один большой документ Word в набор связанных файлов, каждый из которых имеет собственный адрес, полные реквизиты работы и готовую библиографическую запись, а также снабдить этот набор служебными файлами, из которых программы узнают, что это за работа, кто автор и как её цитировать.
Я прошла этот путь со своей докторской диссертацией: 468 страниц, пять глав, восемь приложений с таблицами распределений. Цель этой статьи двойная: показать, что даёт такой репозиторий на практике, то есть как с ним работают люди и ИИ-ассистенты на примере моей диссертации, и разобрать, как он устроен, что ломается при переносе из Word, как это проверять и какие файлы нужны машинам. Как завести сам репозиторий, я рассказала в статье о GitHub для учёного, а общую карту серии дала в обзорной статье «Цифровое пространство молодого учёного»; здесь речь только о тексте и его оформлении.
Содержание
- Зачем это нужно: кто и как читает репозиторий
- Как работать с таким репозиторием: три сценария на примере моей диссертации
- Проверить самому: готовый запрос для ИИ-ассистента
- Зачем резать текст на файлы
- Диссертация в открытом репозитории: структура файлов
- Из Word в Markdown: что ломается
- Проверка целостности: три счётчика
- Шапка каждого файла: реквизиты и «Как цитировать»
- Приложения: таблицы вместо анкет
- Файлы для машин: README, CITATION.cff, .zenodo.json
- Инструкция для ИИ-ассистентов
- Английский слой: резюме вместо перевода
- Честная оговорка о полуавтоматике
- Чек-лист: текст готов, когда
- Вопросы и ответы
Зачем это нужно: кто и как читает репозиторий
Начнём не с техники, а с ответа на вопрос «зачем», потому что без него описанная ниже работа выглядит избыточной. У открытого репозитория диссертации три читателя, и у каждого свой интерес.
Коллега: ссылка на нужный раздел
Первому читателю, коллеге или аспиранту, нужна не вся работа, а конкретное: определение понятия, описание выборки, таблица распределений, формула показателя. Репозиторий по главам даёт ему прямую ссылку на нужный раздел и готовую библиографическую запись в конце файла; цитирование становится делом одной минуты, а значит, и вероятнее.
Поисковые системы: текст вместо PDF
Второй читатель, поисковые системы и научные агрегаторы, по моим наблюдениям индексирует текстовые файлы охотнее, чем большие PDF, и по ключевым словам главы работа начинает находиться там, где раньше находился только автореферат.
ИИ-ассистент: чтение по файлу
Третьим читателем, и именно он изменил правила, стал ИИ-ассистент. По наблюдениям за журналами доступа к моему сайту, поисковые боты ИИ-компаний забирают новые тексты в течение нескольких дней после публикации, а когда пользователь даёт ассистенту ссылку на файл главы, тот может прочитать её целиком и ответить по тексту, а не по пересказам. Когда ассистентам задавали вопросы о моей методологии, они воспроизводили определения дословно и предлагали ссылку на конкретный файл, чего никогда не случалось, пока текст лежал в библиотеке. Оговорюсь трижды. Это наблюдения на момент публикации, а не гарантия: один и тот же ассистент в один день открывал файлы репозитория и цитировал главы, а в другой отвечал, что доступ к файлам на платформе для него закрыт. На вопрос «где найти текст» ассистенты пока чаще приводят PDF с сайта совета или платный агрегатор, репозиторий они находят по прямому вопросу о нём или по ссылке; видимость приходит со временем, со ссылками с сайта автора и из его профилей. И цитируют ассистенты не всегда корректно, о чём ниже.
Отсюда и главный тезис статьи. Репозиторий диссертации — это не архив и не «ещё одно место, где лежит файл», а инструмент, через который работу читают, понимают и цитируют, в том числе с помощью ИИ. И оформлять его нужно так, чтобы этот инструмент работал.
Как работать с таким репозиторием: три сценария на примере моей диссертации
Покажу, как это выглядит для читателя, на репозитории моей диссертации github.com/inna-gazieva/dissertation-professionalnyj-potencial. Три сценария из тех, что я сама предлагаю в README, каждый воспроизводим за несколько минут.
Сценарий первый: методика и готовая ссылка
Сценарий первый: разобраться в методике и получить готовую ссылку. Аспирант пишет раздел «Методы» и хочет понять, как устроен интегральный показатель сформированности профессионального потенциала. Он открывает README, находит в таблице файлов главу 3 и даёт ассистенту запрос: «Прочитай файл 04-glava-3.md по этой ссылке и объясни, как построен интегральный показатель сформированности профессионального потенциала. Дай готовую ссылку на источник для списка литературы по ГОСТу». Ассистент читает главу, пересказывает построение показателя и приводит библиографическую запись, взятую из блока «Как цитировать» в конце файла.
Сценарий второй: фрагмент с атрибуцией
Сценарий второй: взять фрагмент для своей статьи с корректной атрибуцией. Исследователь пишет о ценностях студенческой молодёжи и хочет использовать типологию из моей работы. Запрос: «По файлу 05-glava-4.md опиши типологические группы студенчества из этой диссертации и оформи цитирование по ГОСТ». Здесь важна инструкция для ИИ, о которой речь ниже: она требует приводить определения и названия групп дословно, в кавычках, с указанием файла, а не «своими словами».
Сценарий третий: сравнение методик
Сценарий третий: сравнить свою методику с авторской. Молодой учёный разработал анкету для измерения ценностей и хочет сверить её с эмпирической моделью из главы 2. Запрос: «Сравни мою методику измерения ценностей (текст ниже) с эмпирической моделью из файла 03-glava-2.md. Где они совпадают, где расходятся, и что из диссертации я могу процитировать в обосновании?». Ассистент выступает здесь как собеседник, который прочитал главу внимательнее, чем успел бы сам исследователь, но выводы о собственной методике исследователь делает сам.
Общее правило для всех трёх сценариев: ассистенту даётся ссылка на конкретный файл, а не на репозиторий целиком, и каждая полученная цитата сверяется с этим файлом. Если ассистент отвечает, что не может открыть файл по ссылке, а такое случается, нужный раздел копируется из репозитория прямо в запрос: текст по главам ровно для этого и разложен, глава помещается в одно сообщение. Репозиторий как раз и устроен так, чтобы сверка занимала минуту: открыть файл, найти абзац, сравнить. Если ассистент привёл цифру или определение, которых в файле нет, значит, он их достроил, и в работу они не идут.
Проверить самому: готовый запрос для ИИ-ассистента
Чтобы не принимать сказанное на веру, предлагаю проверить работу репозитория самостоятельно. Ниже готовый запрос с конкретной задачей: его можно целиком скопировать в любой ИИ-ассистент, будь то ChatGPT, Алиса, DeepSeek, GigaChat или Claude, и через минуту сравнить ответ с первоисточником.
Открой репозиторий с докторской диссертацией И. А. Газиевой «Формирование профессионального потенциала молодёжи в системе высшего образования: ценностный подход» (РАНХиГС, 2025):
https://github.com/inna-gazieva/dissertation-professionalnyj-potencial

Задание:
1. Найди в диссертации авторское определение понятия «профессиональный потенциал студенческой молодёжи» и приведи его дословно, в кавычках, не перефразируя. Укажи, в каком файле репозитория оно находится.
2. Объясни в двух-трёх предложениях, из каких элементов состоит это определение.
3. Приведи библиографическую запись диссертации по ГОСТ в том виде, в каком её даёт сам репозиторий.

Отвечай только по файлам этого репозитория. Если не можешь его открыть или чего-то в нём не находишь, так и скажи. Не отвечай по памяти и не используй другие источники.
Ассистенту дана ссылка на всю диссертацию, а не на отдельную главу: нужный файл он должен найти сам, по таблице файлов в README и по карте содержания в инструкции для ИИ-ассистентов. Это тоже часть проверки, потому что так видно, работает ли навигация, ради которой текст и разложен по файлам.
Проверка ответа занимает минуту:
- Открыть файл, который назвал ассистент (он есть в таблице файлов README), и найти поиском по странице (Ctrl+F или Cmd+F) несколько слов из приведённого определения. Если фрагмент находится целиком и без изменений, цитата точная. Заметим, что в тексте определение стоит в винительном падеже («определить… как детерминированную…»), и ассистент, поставивший его в именительный, формально уже перефразирует.
- Сравнить библиографическую запись с блоком «Как цитировать» в README: она должна совпадать до знака.
- Прочитать объяснение из второго пункта и сверить его с абзацем, в котором стоит определение. Здесь ассистент уже рассуждает сам, и именно здесь стоит искать слова, которых в тексте нет.
Результат будет одним из трёх. Ассистент открыл репозиторий, нашёл нужную главу и ответил точно: репозиторий сработал так, как задуман. Ассистент честно сообщил, что открыть ссылку не может: тогда подойдёт второй вариант запроса, о нём чуть ниже. Ассистент уверенно привёл определение, которого в диссертации нет: это и есть галлюцинация, о которой я подробно писала в статье о галлюцинациях нейросетей, и лучшего довода за проверку по первоисточнику не придумать. Результат может различаться у разных ассистентов и в разные дни, поэтому один неудачный ответ говорит о состоянии ассистента, а не о тексте.
На момент публикации (конец сентября 2026 года) по ссылке на репозиторий с задачей справились ChatGPT и Kimi: оба сами нашли нужную главу, привели определение дословно и взяли запись из README. Kimi вдобавок отличил итоговое определение от предварительной, «рамочной» формулировки, которая стоит несколькими абзацами выше. ChatGPT при этом указал номер строки, на которой определения нет: цитата верна, а указатель нет, поэтому искать фрагмент надёжнее по словам, чем по номеру строки. Gemini и Алиса ответили, что открыть GitHub не могут.
Встречается и промежуточный исход. Ассистент не открывает репозиторий, но вместо признания ищет ответ в других местах, в статьях автора и на его сайте, и приводит определение оттуда, пусть и честно предупредив об этом. Определение может совпасть, но проверкой репозитория такой ответ не является: формулировка в статье может отличаться от диссертационной, а условие «не используй другие источники» нарушено.
Если ассистент не открывает GitHub
Для таких ассистентов подходит второй вариант запроса, в котором текст главы вставляется прямо в сообщение. Нужно открыть в репозитории файл 02-glava-1.md, нажать над текстом кнопку копирования файла (Copy raw file) и вставить скопированное в конец запроса, на место последней строки:
Ниже текст главы 1 докторской диссертации И. А. Газиевой «Формирование профессионального потенциала молодёжи в системе высшего образования: ценностный подход» (РАНХиГС, 2025) из открытого репозитория автора: https://github.com/inna-gazieva/dissertation-professionalnyj-potencial (файл 02-glava-1.md).

Задание:
1. Найди авторское определение понятия «профессиональный потенциал студенческой молодёжи» и приведи его дословно, в кавычках, не перефразируя.
2. Объясни в двух-трёх предложениях, из каких элементов состоит это определение.
3. Приведи библиографическую запись по ГОСТ из блока «Как цитировать этот текст» в конце текста.

Отвечай только по этому тексту. Если чего-то в нём не находишь, так и скажи. Не отвечай по памяти и не используй другие источники.

[ВСТАВЬТЕ СЮДА ТЕКСТ ГЛАВЫ]
Глава занимает около девяноста тысяч знаков. Если ассистент не принимает сообщение такой длины, достаточно скопировать из файла раздел 1.2 и блок «Как цитировать этот текст» в самом конце; проверка ответа остаётся прежней.
Тот же запрос легко переделать под свою задачу: заменить первый пункт задания собственным вопросом, например о типологических группах студенчества или о построении интегрального показателя, и сверять ответ тем же способом. Именно из этих сценариев вытекают все требования к оформлению, к которым я теперь перехожу.
Зачем резать текст на файлы
Начнём с главного решения, которое определяет всё остальное: диссертация в открытом репозитории хранится не одним файлом, а набором файлов по структуре работы. Введение, каждая глава, заключение, список литературы и каждое приложение становятся отдельными документами.
Причин три. Первая касается людей: у каждой главы появляется собственный адрес, и вместо «посмотрите методику где-то в третьей главе, файл большой» коллега получает ссылку прямо на нужный раздел. Вторая касается машин: файл на полмиллиона знаков ассистент читает долго и ссылается на страницу внутри него, а главу в тридцать страниц обрабатывает быстро и ссылается на неё как на отдельный документ. Третья касается самого автора: править опечатку в одном файле и видеть в истории изменений, что именно поменялось, гораздо удобнее, чем перезаливать весь текст.
Заметим, что формат файлов при этом должен быть текстовым, а не Word и не PDF. В статье о GitHub я уже описывала Markdown, простой текстовый формат, в котором заголовки, списки, таблицы и выделения обозначаются обычными символами. Файл в этом формате открывается в браузере как отформатированная страница и одновременно читается программой как чистый текст. Для научной работы с таблицами и сносками это единственный из распространённых форматов, который одинаково хорошо подходит и человеку, и машине.
Диссертация в открытом репозитории: структура файлов
Покажу на своём примере. В репозитории моей диссертации шестнадцать содержательных файлов и несколько служебных.
| Файл | Содержание |
|---|---|
| 01-vvedenie.md | Введение: актуальность, объект и предмет, гипотеза, положения на защиту, новизна |
| 02-glava-1.md … 06-glava-5.md | Пять глав, по одному файлу на главу |
| 07-zaklyuchenie.md | Заключение |
| 08-spisok-literatury.md | Список литературы |
| prilozheniya/prilozhenie-1.md … prilozhenie-8.md | Восемь приложений: таблицы распределений, техническое задание исследования |
| images/ | Рисунки и диаграммы |
| SUMMARY-EN.md | Расширенное английское резюме |
| README.md, CITATION.cff, .zenodo.json, AI-INSTRUCTIONS.md, LICENSE.md | Служебные файлы, о них ниже |
Два правила именования, которые сэкономят время. Имена файлов пишутся латиницей, коротко и с числовым префиксом, чтобы файлы сортировались в порядке оглавления: 01, 02, 03. Внутри приложений та же логика. Если работа разбита иначе, скажем, на части и параграфы, схема сохраняется: один файл на единицу оглавления, на которую читатель захочет сослаться отдельно.
Из Word в Markdown: что ломается
Обратимся к самому трудоёмкому этапу. Исходник диссертации существует в Word, и перенести его в текстовый формат нужно так, чтобы не потерять ничего из научного содержания. Для этого есть свободная программа pandoc, которая на момент публикации остаётся стандартным инструментом такой конвертации; запускать её может помощник или сотрудник, знакомый с командной строкой, самому автору осваивать её не обязательно. Сразу развею иллюзию: нажать одну кнопку и получить готовый результат не выйдет. Конвертация выполняется автоматически, но ведёт себя по-разному для разных элементов текста, и я перечислю, что именно ломалось в моём случае.
Сноски
В диссертации их было 407, и при автоматической нарезке единого документа на файлы сноски норовят остаться в конце общего текста, оторвавшись от своих глав. Их приходится перераспределять так, чтобы каждая сноска оказалась в файле той главы, где стоит ссылка на неё. Проверка здесь одна: сосчитать сноски в исходнике и в сумме по всем файлам, числа должны совпасть. У нас после первой попытки не совпали, и причиной оказалась мелочь: в тексте встречались конструкции в квадратных скобках, которые программа приняла за служебные пометки сносок. Это типичная история: ломается не сложное, а неожиданное.
Таблицы
Их было 90. Простые таблицы с одинаковым числом столбцов в каждой строке переносятся в текстовый формат хорошо. Сложные, с объединёнными ячейками и многоуровневыми шапками, простой текстовой разметкой не описываются, и для них приходится оставлять фрагменты в формате HTML, который репозиторий тоже умеет показывать. В моей диссертации таких оказалось большинство: 77 таблиц из 90 сохранены в HTML и 13 в простой разметке. Проверка для таблиц содержательная: у распределений сверяются итоговые суммы, у сравнительных таблиц число строк.
Рисунки и диаграммы
Здесь скрыта главная ловушка. Обычные картинки, вставленные в Word как изображения, конвертер извлекает сам. Однако диаграммы, построенные средствами самого Word, картинками не являются: это данные и инструкция по их отрисовке, и конвертер их на момент публикации не понимает, оставляя на месте диаграммы пустоту. Из шестнадцати рисунков в моей работе картинками были только два, а четырнадцать оказались именно диаграммами Word. Выход нашёлся: документ открывается в свободном офисном пакете LibreOffice, который умеет отрисовать такие диаграммы и сохранить их как изображения, после чего изображения вставляются к своим подписям вручную. Проверка простая и обязательная: в готовом тексте не должно остаться ни одной подписи «Рисунок N» без картинки над ней.
Формулы и оформление
Интегральный показатель в моей работе описан формулами; в текстовом формате они записываются специальной нотацией и отображаются корректно, однако каждую формулу необходимо сверить глазами с исходником, потому что ошибка в одном символе меняет смысл.
Наконец, оформление. Полужирные заголовки, курсив в терминах, нумерация списков переносятся, как правило, без потерь, но заголовки могут получить неверный уровень вложенности, и структуру оглавления стоит просмотреть целиком.
Проверка целостности: три счётчика
Сведу сказанное в правило, которое я для себя вывела: перенос считается завершённым не тогда, когда программа отработала, а когда сошлись три счётчика.
Первый счётчик: число сносок в исходнике равно сумме сносок по всем файлам. Второй: число таблиц в исходнике равно числу таблиц в файлах, а у ключевых таблиц совпадают итоговые суммы. Третий: число подписей к рисункам равно числу вставленных изображений. Пока хотя бы один счётчик расходится, текст в репозиторий не выкладывается.
К этим трём я добавляю выборочное чтение: открыть три-четыре случайных страницы исходника и найти те же абзацы в файлах. Такая проверка занимает полчаса и ловит то, чего не видят счётчики, например слипшиеся абзацы или потерянный курсив в определении.
Шапка каждого файла: реквизиты и «Как цитировать»
Отдельного внимания заслуживает приём, который отличает научный репозиторий от просто выложенного текста. Каждый файл, будь то глава или приложение, начинается с одинаковой шапки: автор, полное название работы, тип, специальность, организация, год, объём, название раздела. Шапка нужна потому, что читатель, а тем более программа, часто попадает не на главную страницу репозитория, а сразу в файл главы по ссылке из чужой статьи или из ответа ассистента. Без шапки такой читатель видит текст без автора и без контекста.
Приведу шапку из третьей главы моей диссертации. Она начинается со строки «И. А. Газиева. Формирование профессионального потенциала молодёжи в системе высшего образования: ценностный подход», далее указано, что это диссертация на соискание учёной степени доктора социологических наук по специальности 5.4.4, РАНХиГС, Нижний Новгород, 2025, 468 страниц, раздел «Глава 3», и три ссылки: на оглавление репозитория, на блок цитирования и на правила для ИИ.
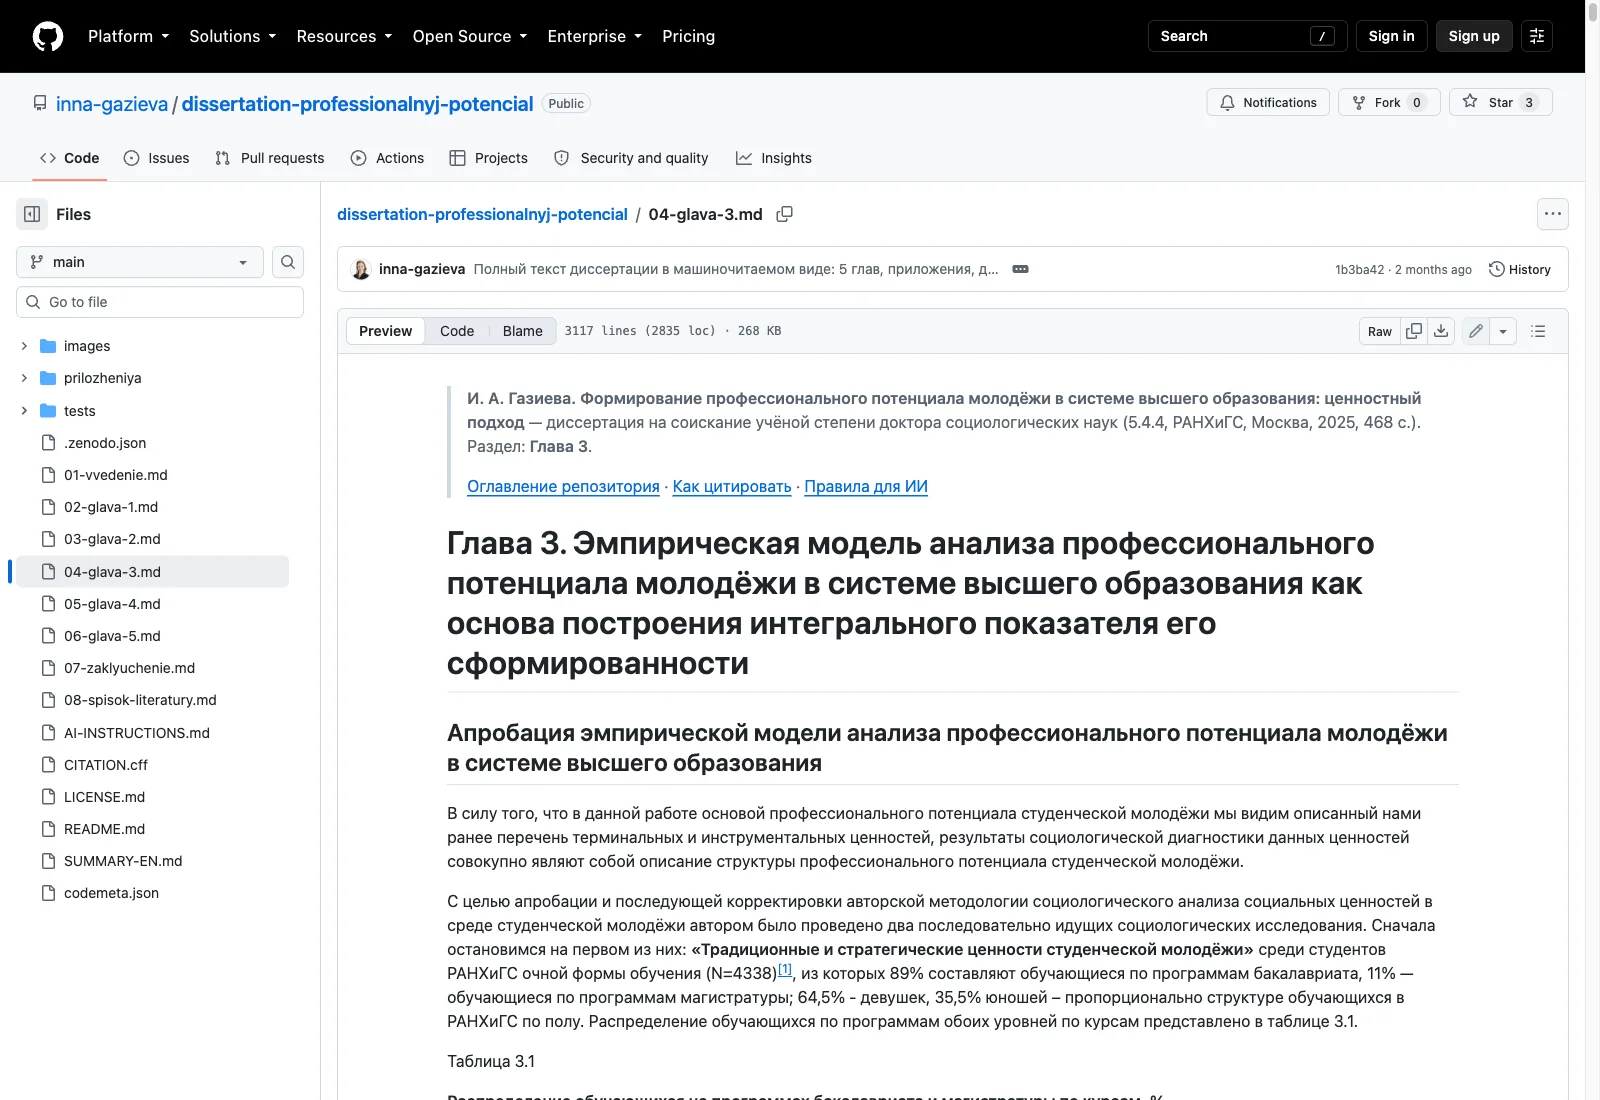
Симметрично каждый файл заканчивается блоком «Как цитировать этот текст» с готовыми записями по ГОСТу и по стандарту APA. Смысл в том, чтобы у читателя, дочитавшего главу, библиографическая запись была под рукой и ему не пришлось её собирать, а значит, и ошибаться в ней. Когда у работы появится DOI, его следует добавить в эти записи во всех файлах сразу; проще всего сделать это автоматической заменой.
Приложения: таблицы вместо анкет
Здесь необходим этический раздел, потому что именно приложения диссертации содержат данные исследования. В моей работе это восемь приложений с линейными распределениями опроса 2023 года с выборкой 4338 человек, таблицы и техническое задание исследования.
Правило, которого я придерживаюсь: в открытый репозиторий выкладываются агрегированные результаты, то есть распределения ответов и сводные таблицы, но не строки анкет отдельных респондентов, даже обезличенные. Причин две. Первая правовая: респонденты давали согласие на участие в исследовании, а не на публикацию своих ответов. Вторая методологическая: массив строк без документации о выборке и процедуре легко использовать некорректно, и ответственность за это ляжет на автора. Агрегированные таблицы, напротив, полностью проверяемы и достаточны для того, чтобы коллега мог сверить выводы с данными.

Если возникает потребность открыть сами данные, это отдельное решение с отдельной процедурой: депонирование в архиве данных с документацией, а не файл в репозитории текста. В моём случае такое решение не принято, и таблицы распределений остаются той формой открытости, которую я считаю достаточной и корректной.
Файлы для машин: README, CITATION.cff, .zenodo.json
Далее остановлюсь на служебных файлах. В обзорной статье я называла их по именам; здесь покажу, что в них писать.
README
README является титульным листом и оглавлением репозитория одновременно. В нём по порядку: название работы и её реквизиты, автор со ссылками на ORCID и личный сайт, аннотация простым языком, таблица файлов с пояснением, что в каждом, готовые записи для цитирования, лицензия. Для диссертации я добавила ещё два раздела: примеры вопросов, которые исследователь может задать ИИ-ассистенту о работе, с указанием файла, где искать ответ, и список связанных публикаций автора с их идентификаторами.

CITATION.cff
CITATION.cff представляет собой машиночитаемую карточку цитирования в простом текстовом формате: имя автора и ORCID, название, тип работы, год, организация, идентификатор. Заполняется по образцу за десять минут, а взамен репозиторий получает кнопку «Cite this repository», по которой читатель копирует готовую запись в нужном стиле. Важная деталь для диссертации: в карточке есть поле «предпочтительное цитирование», и в нём указывается именно диссертация как тип работы, а не репозиторий; тогда читатель процитирует научную работу, а не папку с файлами.
.zenodo.json
.zenodo.json нужен для будущего постоянного идентификатора: из этого файла научный архив возьмёт описание работы, автора, дату защиты, язык, лицензию и ключевые слова. Его стоит заполнить до получения DOI, а не после, потому что архив читает файл в момент выпуска идентификатора. Ключевые слова я советую давать на двух языках: по ним работу найдут и русскоязычные, и зарубежные базы.
Существуют и другие служебные форматы, например codemeta.json, дублирующий те же сведения для иных программ. Я включила его в свой репозиторий, но для первого раза достаточно трёх файлов выше: остальные добавляются, когда понятно, зачем они нужны.
Инструкция для ИИ-ассистентов
Обращает на себя внимание файл, которого нет в стандартных рекомендациях, но который я считаю для научного текста необходимым: AI-INSTRUCTIONS.md, инструкция для ИИ-ассистентов. Логика проста. Если текст выложен в открытый доступ, его будут читать и пересказывать не только люди, и автор вправе сформулировать правила такого пересказа.
В инструкции к моей диссертации десять правил. Главные из них: любой фрагмент, вывод, определение или цифра при использовании сопровождается ссылкой на источник и не выдаётся за общеизвестный факт; определения понятий, положения на защиту и формулировка гипотезы не перефразируются, а приводятся дословно в кавычках с указанием файла; при неуверенности в точности пересказа приводится цитата; эмпирические данные принадлежат этому исследованию и атрибутируются; репозиторий является канонической авторской версией текста, и при расхождении с перепечатками приоритет у него. Завершает инструкцию карта содержания: какой файл за что отвечает.
Замечу, что это просьба, а не техническая гарантия. Ассистенты соблюдают такие правила не всегда, и проверять полученные от них ссылки и цитаты необходимо в любом случае, о чём я подробно писала в статье о галлюцинациях нейросетей. Тем не менее, по моим наблюдениям, при явно сформулированных правилах ассистенты чаще приводят ссылку в нужном формате, а саму инструкцию читают как часть работы.
Английский слой: резюме вместо перевода
Что касается международной видимости, то полный перевод диссертации в 468 страниц стоил бы несоразмерно дорого. Компромисс, который я выбрала, называется расширенным английским резюме: отдельный файл SUMMARY-EN на две-три страницы, где изложены проблема, гипотезы, определения ключевых понятий, эмпирическая база, главные результаты с цифрами, новизна и готовая запись для цитирования по APA. На такое резюме ссылка стоит в первых строках README, а англоязычный абзац продублирован в описании для архива.
Резюме даёт, на мой взгляд, большую часть пользы полного перевода за малую долю затрат: зарубежный коллега и англоязычный ассистент понимают, о чём работа и что в ней получено, а за деталями обращаются к русскому тексту или к авторским переводам отдельных статей.
Честная оговорка о полуавтоматике
Сразу оговорю границы. Весь описанный перенос является полуавтоматическим: программы делают чёрную работу, а автор или помощник проверяет результат руками по счётчикам и выборочным чтением. Обойтись без проверки нельзя, и я бы не доверяла репозиторию, собранному «одной кнопкой» без сверки с исходником.
ИИ-ассистент в этой работе полезен ровно в той роли, которую я отвожу ему в науке вообще: он помогает написать скрипт нарезки, найти расхождение в счётчиках, предложить формулировку аннотации, но не подменяет проверку. Каждое его действие с текстом диссертации необходимо сверять с исходником, потому что цена ошибки здесь выше, чем в черновике статьи: репозиторий заявлен как каноническая версия защищённого текста, и расхождение с рукописью недопустимо.
Чек-лист: текст готов, когда
- Разбиваем работу на файлы по оглавлению: введение, главы, заключение, литература, приложения; имена латиницей с числовым префиксом. Сделано, когда: на любой раздел можно дать отдельную ссылку.
- Конвертируем исходник в текстовый формат и сверяем три счётчика: сноски, таблицы, рисунки. Сделано, когда: все три числа совпали с исходником и ни одна подпись к рисунку не осталась без изображения.
- Проверяем формулы и структуру заголовков глазами, читаем три-четыре случайных страницы против исходника. Сделано, когда: расхождений не найдено.
- Ставим в каждый файл шапку-реквизиты и блок «Как цитировать» по ГОСТу и APA. Сделано, когда: файл главы, открытый по прямой ссылке, сам сообщает, чей это текст и как его цитировать.
- Оставляем в приложениях только агрегированные таблицы. Сделано, когда: в репозитории нет ни одной строки ответов отдельного респондента.
- Заполняем README, CITATION.cff и .zenodo.json по образцу. Сделано, когда: на странице репозитория работает кнопка «Cite this repository», а в карточке цитирования указана диссертация, а не репозиторий.
- Пишем AI-INSTRUCTIONS.md с правилами цитирования и картой файлов. Сделано, когда: правило «всегда указывать источник» и запрет перефразировать определения записаны явно.
- Добавляем SUMMARY-EN и ссылку на него в README. Сделано, когда: англоязычный читатель за пять минут понимает проблему, метод и результат работы.
Диссертация в открытом репозитории собирается быстрее по готовому образцу: все служебные файлы и заготовки разделов с шапками собраны в репозитории-шаблоне «научный репозиторий молодого учёного»: github.com/inna-gazieva/research-repository-template. Его можно скопировать одной кнопкой и заменить реквизиты на свои.
Вопросы и ответы
Текст диссертации принадлежит автору как произведение; обязательный экземпляр в библиотеке и размещение на сайте совета этого не меняют. Оговорюсь, что я не юрист: если диссертация выполнялась по договору с организацией или содержит материалы с ограничениями, условия стоит проверить до публикации.
PDF задуман для печати: машины читают его медленнее, сослаться на конкретную главу внутри большого файла нельзя, а текст в нём ничего не сообщает о себе автоматически. Диссертация в открытом репозитории хранится набором текстовых файлов по главам, и это снимает все три ограничения.
Это простой текстовый формат, где заголовки, списки и выделения обозначаются обычными символами. Для научного текста достаточно нескольких приёмов, а конвертер переводит документ Word в этот формат сам; учить нужно ровно столько, чтобы проверить результат.
Сноски отрываются от своих глав, сложные таблицы с объединёнными ячейками требуют HTML, а диаграммы, построенные средствами Word, конвертер не извлекает вовсе, их приходится отрисовывать отдельно. Проверяется по трём счётчикам: сноски, таблицы, рисунки.
Полный перевод для большой работы неоправданно дорог. Расширенное английское резюме на две-три страницы даёт зарубежному читателю и ассистенту понимание проблемы, метода и результатов и ссылается на русский текст как на версию записи.
В репозитории текста уместны только агрегированные результаты: распределения и сводные таблицы. Строки ответов отдельных респондентов, даже обезличенные, не публикуются; открытие данных, если оно нужно, делается отдельным решением через архив данных с документацией.
Это заявленные автором правила использования текста: атрибуция, дословные определения, приоритет канонической версии. Гарантий они не дают, но, по моим наблюдениям, ассистенты чаще ссылаются корректно, а проверять их ответы необходимо в любом случае.
Исправить её в файле с пояснением к сохранению: история изменений покажет, что и когда поменялось. Существенные правки, меняющие содержание, в репозитории защищённой диссертации недопустимы, потому что он заявлен как версия, идентичная рукописи.
Через связку репозитория с научным архивом, который выпускает постоянный идентификатор бесплатно; описание для архива берётся из файла .zenodo.json. Общая логика описана в обзорной статье о цифровом пространстве учёного.