Научная работа сегодня всё реже заканчивается в момент выхода статьи. Текст, данные, анкета, программа обработки, список литературы продолжают жить после публикации: их просят коллеги, их проверяют рецензенты, их читают поисковые системы и ИИ-ассистенты. При этом инфраструктура, в которой молодой учёный привык хранить свои материалы, к такой жизни не приспособлена: файлы лежат в облаке под именами вроде «статья_финал_3», ссылка на них меняется при каждом переезде, а история правок недоступна никому, включая самого автора.
Проблема молодого исследователя в том, что у большей части его работы нет постоянного адреса. Журнальная статья такой адрес имеет: выходные данные, страницу в базе, ссылку, по которой её найдут и через десять лет. Но анкета и данные опроса, таблицы и расчёты, полный текст диссертации, доклады и авторские переводы в журнал не попадают. Они существуют только в виде файлов на личном компьютере или во вложениях к письмам, и на них нельзя ни сослаться, ни проверить их, ни отследить, что в них менялось. Коллега не может сверить расчёт, рецензент не может посмотреть данные, а поисковая система и ИИ-ассистент не в состоянии понять, кто автор файла и что это за документ.
Открытость данных и материалов постепенно становится нормой в грантовых требованиях и редакционных политиках журналов, а для их хранения научное сообщество всё чаще берёт инструмент, который ещё недавно считался принадлежностью программистов.
Что же такое GitHub и зачем он учёному, который не пишет ни строчки кода? По сути, это онлайн-платформа, где любой проект хранится в виде «репозитория», то есть папки с публичной страницей, полной историей изменений и постоянным адресом каждого файла. Программирование для работы с ней не требуется: файлы создаются, загружаются и редактируются прямо в браузере.
Я завела свой аккаунт летом 2026 года, уже будучи доктором наук, и прошла весь путь с нуля: регистрацию, оформление профиля, первый репозиторий, а заодно и две ошибки, которые стоили мне времени и нервов. Цель этой статьи практическая: показать молодому учёному, как завести GitHub так, чтобы аккаунт с первого дня работал на научную репутацию, и уберечь от ошибок, которые я совершила сама. Эта статья продолжает разговор о профилях и идентификаторах молодого учёного и открывает практическую часть серии, общую карту которой я дала в обзорной статье «Цифровое пространство молодого учёного». Получение DOI, архивирование и оформление текста диссертации в репозитории здесь намеренно не разбираются: эта статья только о первом шаге.
Содержание
- Зачем учёному репозиторий: пять причин
- GitHub на языке учёного: четыре понятия
- Регистрация: имя пользователя как идентификатор
- Ошибка первая: аккаунт, которого не существует
- Оформление профиля: страница о себе
- Первый репозиторий: имя, доступ, лицензия
- Ошибка вторая: косая черта в названии
- README: титульный лист научной работы
- Как загружать и править файлы без программирования
- Границы: что на GitHub выкладывать не следует
- Чек-лист: аккаунт за один вечер
- Вопросы и ответы
Зачем учёному репозиторий: пять причин
Прежде чем разбирать термины и кнопки, стоит честно ответить на вопрос, ради чего всё это. Мой ответ складывается из пяти причин, и ни одна из них не про моду на технологии.
Первая причина заключается в том, что у каждого материала появляется постоянный адрес. Анкета, таблицы с распределениями, программа обработки, текст доклада, авторский перевод статьи получают ссылку, на которую можно сослаться в статье, в заявке на грант, в письме рецензенту, и через год она будет работать.
Вторая причина состоит в истории версий. Каждое сохранение подписано и датировано, поэтому любой читатель видит, что текст после публикации не переписывался, а если уточнялся, то что именно. У файла на компьютере такой прозрачности нет по определению.
Третья причина связана с тем, кто сегодня читает научные тексты. Открытый текст в репозитории индексируют поисковые системы и читают ИИ-ассистенты, а статья за платным доступом или PDF во вложении к письму для них недоступны или доступны лишь частично. В обзорной статье о цифровом пространстве я подробно разбирала, почему открытые работы попадают в ответы ассистентов заметно охотнее закрытых; репозиторий и есть самый простой способ сделать работу открытой.
Четвёртая причина в том, что репозиторий открывает дорогу к постоянному идентификатору. Его можно связать с научным архивом, который присваивает работе DOI, и тогда у диссертации, доклада или перевода появляется постоянная ссылка того же типа, что у журнальной статьи. Так, у полного текста моей диссертации есть DOI, хотя ни один журнал её целиком, разумеется, не публиковал.
Пятая причина касается автора, а не работы. Репозиторий со ссылками на ORCID и личный сайт становится ещё одним узлом, по которому поисковые системы и ИИ-ассистенты собирают записи об одном человеке в единую сущность, а не в набор однофамильцев. О том, как устроена эта связка профилей, я писала в статье о профилях и идентификаторах.
Репозиторий при этом не заменяет ни рецензирования, ни публикации в журнале, ни защиты: это инфраструктура вокруг результата, а не сам результат.
GitHub на языке учёного: четыре понятия
Теперь о понятиях, без которых интерфейс платформы кажется чужим. Их всего четыре.
«Репозиторий» (repository) представляет собой папку проекта с собственной публичной страницей. У научной работы это, например, папка с текстом диссертации, разбитым на главы, или папка с одной статьёй и приложениями к ней. Каждый файл в репозитории получает постоянный адрес, по которому его можно открыть в браузере без скачивания.
«Коммит» (commit) означает сохранение изменений с обязательным коротким пояснением: «исправлены опечатки в третьей главе», «добавлен список литературы». Из таких сохранений складывается история репозитория, в которой видно, что, когда и зачем менялось.
README является главным файлом репозитория: его содержимое платформа показывает прямо на странице проекта, под списком файлов. Для учёного это титульный лист работы, о котором подробно пойдёт речь ниже.
Наконец, Markdown представляет собой простой текстовый формат, в котором заголовки, списки и выделения обозначаются обычными символами: решётка перед строкой делает её заголовком, звёздочки выделяют слово курсивом. Файлы в этом формате имеют расширение .md, открываются в любом редакторе и одинаково легко читаются человеком и программой. Осваивать его специально не нужно: для научного текста достаточно пяти-шести приёмов, а редактор GitHub показывает результат до сохранения.
Заметим, что слова «Git», «ветка», «пул-реквест» и прочие термины из мира разработки учёному на первых порах не понадобятся вовсе. Достаточно репозитория, коммита, README и Markdown.
Регистрация: имя пользователя как идентификатор
Сама регистрация занимает несколько минут: адрес электронной почты, пароль, имя пользователя, код подтверждения из письма. Однако два поля в этой короткой анкете заслуживают отдельного внимания, потому что исправлять их позже дорого.
Первое поле, имя пользователя (username), становится частью адреса профиля и всех репозиториев: github.com/имя-пользователя. Это публичный идентификатор, ничем не отличающийся по смыслу от SPIN-кода или ORCID, о которых я писала в статье о профилях: по нему ссылаются, его указывают в анкетах и в машиночитаемых описаниях работ. Отсюда правило: имя пользователя должно совпадать с тем, как исследователь пишет свою фамилию латиницей в публикациях. Мой аккаунт называется inna-gazieva, ровно так же, как записан автор в ORCID и в международных базах. Имя допускает только латинские буквы, цифры и дефис, причём дефис не может стоять первым, поэтому варианты вроде «inna_gazieva» или «Газиева» не пройдут. Переименовать аккаунт технически возможно, но все внешние ссылки на старый адрес, включая уже опубликованные в статьях, работать перестанут.
Второе поле, электронная почта, кажется совершенно безобидным. Именно на нём я и споткнулась.
Ошибка первая: аккаунт, которого не существует
Расскажу на собственном опыте. Регистрируясь, я, как мне казалось, поступила по всем правилам: указала «серьёзную» рабочую почту на собственном домене, совпадающем с адресом моего сайта. Аккаунт создался, профиль заполнился, первые репозитории были загружены и помечены как публичные. Со стороны всё выглядело готовым.
Проверка обнаружила обратное. Когда страницу профиля открыли в режиме «инкогнито», то есть глазами постороннего читателя, а не владельца аккаунта, вместо профиля отобразилось сообщение «страница не найдена». Ни профиля, ни репозиториев для внешнего мира не существовало, хотя внутри аккаунта всё было на месте и никаких уведомлений о проблеме не приходило. В настройках обнаружилась лишь пометка о том, что аккаунт «помечен» (flagged) системой защиты от злоупотреблений.
Почти сутки ушли на поиск причины, после чего пришлось обратиться в поддержку платформы через форму восстановления доступа. Ответ пришёл в тот же день, примерно через три часа, и оказался неожиданным: ограничения были наложены из-за адреса электронной почты. Система защиты сочла домен моей почты «временным» или «одноразовым», каким пользуются для массовой регистрации фиктивных аккаунтов. Для снятия ограничений требовалось указать адрес на устоявшемся почтовом сервисе, удалить прежний адрес из аккаунта и убрать любые «пересылающие» адреса. Никаких документов, подтверждения личности или объяснений не потребовалось; поддержка прямо оговорила, что ей не нужно ничего «отслеживаемого», а нужен лишь адрес, которому система доверяет. После замены почты на личный адрес ограничения сняли в течение того же дня.
Мораль этой истории для молодого учёного двойная. Во-первых, регистрироваться следует на давно существующую личную почту, а не на новый адрес на собственном или университетском домене, каким бы солидным он ни казался: адрес на своём домене можно добавить в аккаунт вторым позже, когда аккаунт уже «прижился». Во-вторых, любой новый публичный профиль необходимо проверять из режима «инкогнито» или с чужого устройства, потому что владельцу аккаунта система всегда показывает всё, а читателю, возможно, ничего!
Оформление профиля: страница о себе
После регистрации страница github.com/имя-пользователя пуста, и в таком виде она скорее вредит, чем помогает: пустой аккаунт с одним репозиторием выглядит для читателя случайным, а для систем защиты платформы, как мы уже видели, подозрительным. Оформление занимает не более часа и делается в настройках профиля.
Обязательными я считаю шесть полей. Имя (name) указывается полностью и латиницей, при желании с дублем кириллицей: «Inna Gazieva · Инна Газиева». Фотография должна совпадать с той, что стоит в других профилях, чтобы читатель, пришедший из ORCID или с сайта, узнал автора. Короткая биография (bio) вмещает степень, организацию и одну-две области исследований; регалии здесь уместны минимальные и проверяемые. Поле «сайт» (website) заполняется адресом личной страницы. Для ORCID у платформы есть отдельное поле «ORCID iD» в настройках профиля: идентификатор не вписывается вручную, а подтверждается входом в свою запись ORCID, после чего выводится на странице профиля со значком. Это самый надёжный способ связать аккаунт с научной записью об авторе. Наконец, организация (company) записывается так, как она фигурирует в публикациях.
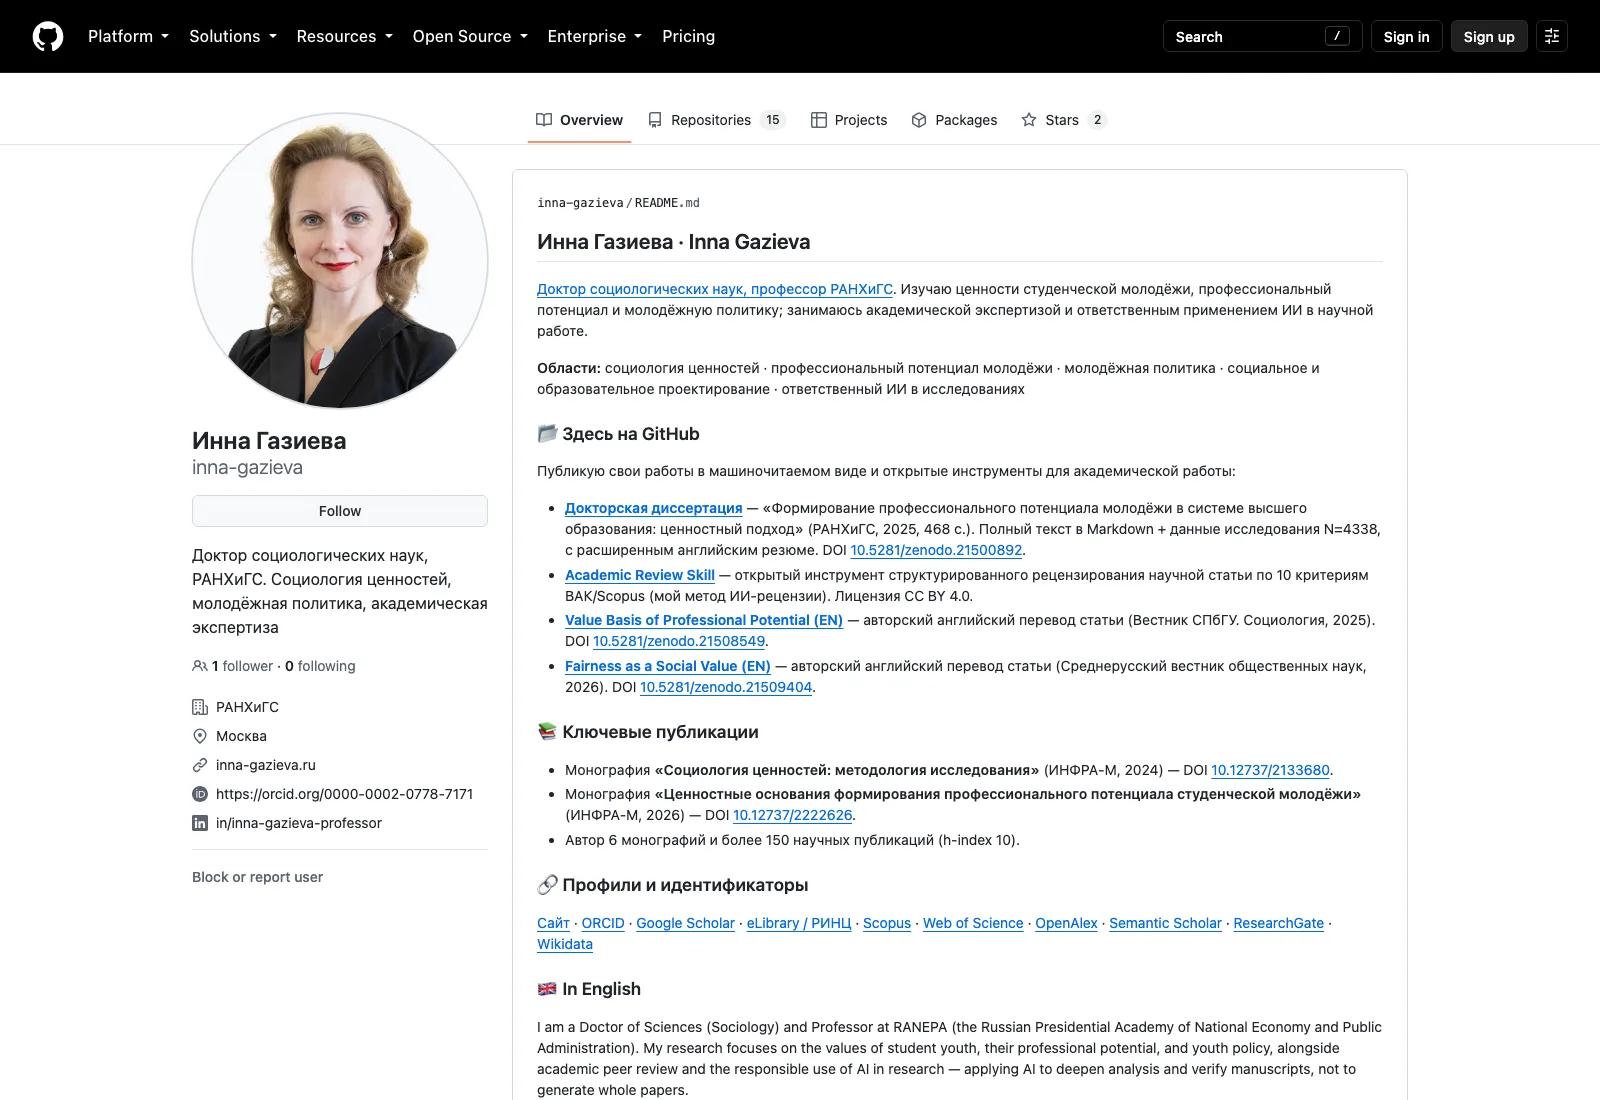
Отдельного внимания заслуживает приём, который платформа предлагает, но не афиширует: если создать репозиторий с названием, в точности совпадающим с именем пользователя, и положить в него файл README, его содержимое будет показано на странице профиля вместо пустого места. Так у учёного появляется полноценная страница о себе: области исследований, список репозиториев с пояснениями, ключевые публикации с DOI и строка ссылок на другие профили. Как это выглядит на практике, можно посмотреть на моей странице github.com/inna-gazieva: там перечислены четыре репозитория с аннотациями, две монографии с идентификаторами и десять профилей от ORCID до Wikidata.
Первый репозиторий: имя, доступ, лицензия
Репозиторий создаётся кнопкой «New repository» и требует ответить на четыре вопроса.
Имя репозитория, как и имя пользователя, становится частью адреса, поэтому оно должно быть коротким, латинским и говорящим: у меня это dissertation-professionalnyj-potencial для диссертации и paper-en-fairness-as-social-value для английского перевода статьи. Транслитерация русских слов допустима, но лучше выбирать имена, из которых понятен тип работы: dissertation, paper, dataset, monograph.
Доступ выбирается публичный (public). Приватный репозиторий имеет смысл на этапе подготовки, однако для научной работы, которую предстоит цитировать, закрытость лишает затею смысла: к приватному репозиторию нельзя привязать постоянный идентификатор, и его не увидят ни коллеги, ни поисковые системы.
Галочку «Add a README file» стоит поставить сразу, чтобы репозиторий не был пустым; наполнить файл можно позже.
Лицензия является единственным пунктом, где нужно подумать заранее, потому что она определяет, что читатели вправе делать с текстом. Для научных текстов приняты лицензии семейства Creative Commons: CC BY разрешает любое использование при указании автора, CC BY-NC исключает коммерческое использование, CC BY-NC-ND дополнительно запрещает создавать производные работы. Я выбрала для диссертации CC BY-NC-ND 4.0, поскольку текст диссертации должен оставаться неизменным, а для авторских переводов статей более свободные варианты. Подчеркну, что лицензию можно ставить только на тексты, права на которые принадлежат автору; издательский макет опубликованной статьи выкладывать под своей лицензией нельзя, и к этому вопросу я вернусь в разделе о границах.
После создания репозитория остаётся заполнить его «шапку», которую платформа называет About: короткое описание, адрес сайта и до двадцати тем (topics), то есть ключевых слов на английском вроде sociology, open-science, dissertation. Описание показывается в поиске по платформе и в результатах поисковых систем; темы помогают найти работу тем, кто ищет по предметной области. У репозитория моей диссертации в описании стоят название работы, организация и год, а среди тем перечислены и предметные (sociology, values, youth), и типовые (dissertation, markdown, open-science).

Ошибка вторая: косая черта в названии
Вторая ошибка мельче первой, но и она стоила времени. Полный адрес репозитория на платформе записывается как «имя-пользователя/имя-репозитория», и именно в таком виде, с косой чертой, он фигурирует во всех инструкциях и ссылках. При создании очередного репозитория в поле «имя» была вставлена вся эта строка целиком. Платформа не выдала ошибки, а молча заменила недопустимый символ на дефис, и репозиторий получил имя вида «-inna-gazieva-paper-en-…»: с дефисом в начале и с удвоенной фамилией.
Лечится это переименованием репозитория в настройках, причём внешние ссылки на старое имя платформа некоторое время перенаправляет на новое. Однако, если адрес уже успел попасть в опубликованную статью или в запись архива с идентификатором, придётся править и их. Урок простой: в поле имени вводится только имя репозитория, без имени пользователя и без косой черты, а результат необходимо сверить с адресом в строке браузера сразу после создания.
README: титульный лист научной работы
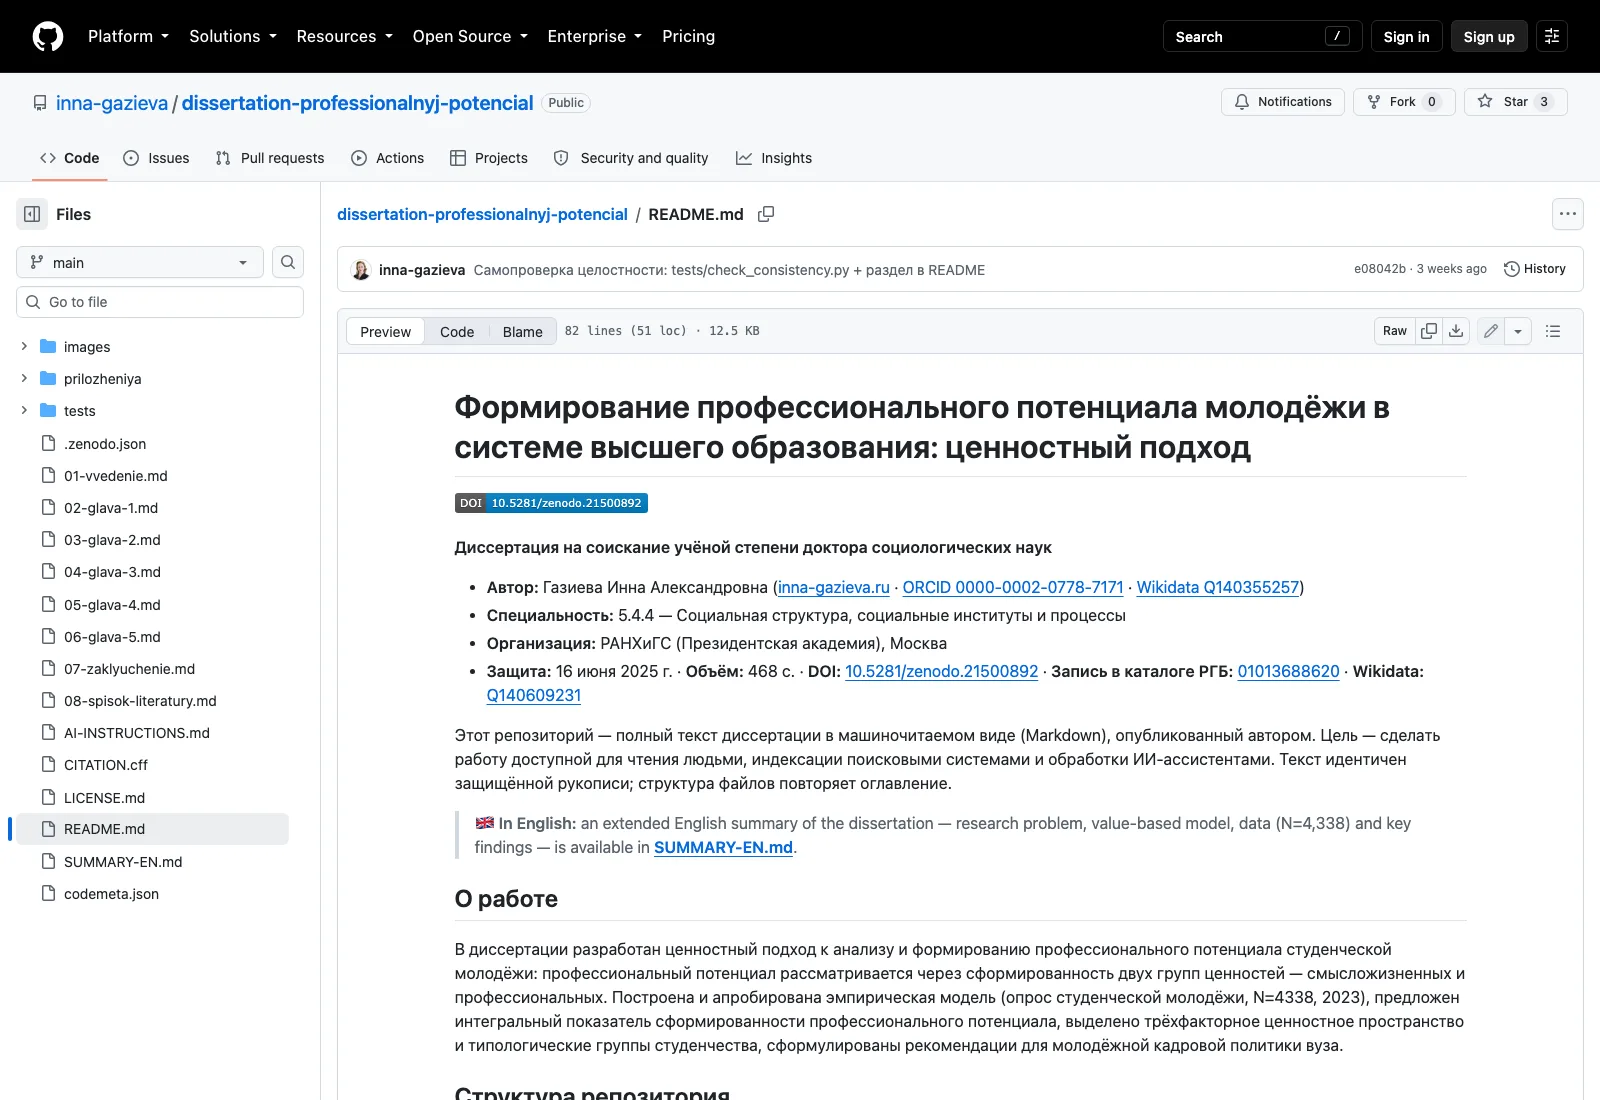
Обратимся к самому важному файлу. README открывается первым и читается чаще всего, поэтому его удобно мыслить как титульный лист вместе с аннотацией и оглавлением, собранные в одном месте. На мой взгляд, хороший README научной работы отвечает на пять вопросов читателя в том порядке, в каком они возникают.
Что это за работа? В первой строке стоит полное название, ниже тип работы и её реквизиты: специальность, организация, год, объём, для диссертации дата защиты и номер записи в каталоге Российской государственной библиотеки.
Кто автор? Фамилия, имя и отчество полностью, кириллицей и латиницей, со ссылками на ORCID и на личный сайт. Если у автора есть запись в Wikidata, о которой шла речь в статье о профилях, ссылка на неё уместна здесь же.
О чём работа? Аннотация в один-два абзаца, написанная простым языком: постановка проблемы, метод, эмпирическая база, главный результат. Это тот текст, который прочтёт и коллега, и поисковая система, и ИИ-ассистент, поэтому в нём должны быть названы ключевые понятия работы.
Из чего она состоит? Таблица файлов с пояснением, что в каждом: введение, главы, заключение, список литературы, приложения. Если текст разбит на главы-файлы, каждая строка таблицы становится ссылкой на конкретный раздел, и читатель попадает сразу в нужную главу вместо того, чтобы искать её в большом документе.
Как её цитировать? Готовая библиографическая запись по ГОСТу и, для международного читателя, по стандарту APA. Приведу пример из README моей диссертации: «Газиева, И. А. Формирование профессионального потенциала молодёжи в системе высшего образования: ценностный подход : дис. … д-ра социол. наук : 5.4.4 / Газиева Инна Александровна ; РАНХиГС. — Нижний Новгород, 2025. — 468 с.». Читателю не придётся собирать описание самостоятельно, а значит, снижается вероятность ошибки в ссылке на работу.
Завершает файл строка о лицензии и, когда работа получит постоянный идентификатор, ссылка на него. У большинства научных репозиториев на платформе в самом верху README стоит небольшой значок с DOI; он появляется после того, как репозиторий связан с научным архивом; как эта связка устроена в целом, описано в обзорной статье серии.
Отдельным приёмом стоит упомянуть короткий раздел «для ИИ-ассистентов»: две-три фразы о том, что при использовании фрагментов текста необходимо указывать источник в приведённом выше формате, и ссылка на файл с подробными правилами. Замечу, что это лишь просьба, а не техническая гарантия: ассистенты соблюдают её не всегда, и проверять ссылки, полученные от ИИ, всё равно необходимо, о чём я подробно писала в статье о галлюцинациях нейросетей. Тем не менее опыт показывает, что явно сформулированное правило цитирования заметно повышает шансы на корректную ссылку.
Как выглядит README, составленный по этой схеме, можно посмотреть в репозитории моей диссертации.
Как загружать и править файлы без программирования
Сразу развею опасение, которое останавливает многих гуманитариев: ни командная строка, ни специальные программы для работы с репозиторием не нужны. Всё делается в браузере.
Загрузка готовых файлов выполняется через кнопку «Add file» и пункт «Upload files»: файлы перетаскиваются в окно браузера, внизу вводится пояснение к сохранению, после чего нажимается кнопка «Commit changes». Точно так же добавляется папка с приложениями. Правка существующего файла выполняется через значок карандаша на странице файла: открывается редактор, в котором слева виден текст с разметкой, а по вкладке «Preview» результат. Каждое сохранение снова сопровождается коротким пояснением.
Два практических совета. Первый: пояснения к сохранениям стоит писать содержательно, как записи в лабораторном журнале, потому что через год именно по ним придётся вспоминать, что менялось. Второй: загружать материалы лучше постепенно, а не десятками репозиториев в первые часы после регистрации: новый аккаунт с внезапной массовой активностью выглядит для систем защиты платформы подозрительно.
Что касается перевода текста из Word в Markdown, то он потребует отдельного разговора: таблицы, сноски и рисунки при таком переводе ведут себя по-разному, и результат необходимо проверять. Этот разговор выходит за рамки статьи о первом шаге.
Границы: что на GitHub выкладывать не следует
Открытость не отменяет права и этику, и об этом необходимо сказать прямо.
Во-первых, издательский макет опубликованной статьи, то есть тот PDF, который скачивается с сайта журнала, принадлежит издателю. Выкладывать его без разрешения нельзя; допустимость размещения авторской рукописи определяется политикой конкретного журнала, и её следует проверить до загрузки. Собственная диссертация, доклады, препринты и авторские переводы принадлежат автору.
Во-вторых, персональные данные респондентов не выкладываются ни в каком виде. Если к работе прилагаются данные опроса, то только в агрегированной форме: таблицы распределений, а не строки анкет отдельных людей. В приложениях к моей диссертации размещены именно такие таблицы по исследованию с выборкой 4338 человек, тогда как сами анкеты остаются закрытыми.
В-третьих, репозиторий не заменяет ни публикацию в рецензируемом журнале, ни защиту, ни саму научную работу. Это способ сделать сделанное видимым, доступным и проверяемым, и не более того. Соблазн создать десяток репозиториев ради «объёма» ничем не отличается от накрутки публикаций, о которой я писала в связи с профилями: пустой или дублирующий репозиторий портит впечатление сильнее, чем его отсутствие.
Чек-лист: аккаунт за один вечер
- Регистрируемся на давно существующую личную почту, не на новый адрес на собственном домене. Имя пользователя выбираем совпадающим с латинским написанием фамилии в публикациях. Сделано, когда: адрес github.com/имя открывается, а имя совпадает с записью автора в ORCID.
- Включаем двухфакторную защиту входа в настройках безопасности: на момент публикации платформа требует её от тех, кто публикует код и релизы или администрирует репозитории, и настоятельно рекомендует всем остальным. Сделано, когда: вход подтверждается кодом из приложения или по резервному способу.
- Проверяем профиль из режима «инкогнито» в браузере. Сделано, когда: страница профиля видна без входа в аккаунт.
- Заполняем профиль: полное имя, фотография, короткая биография, сайт, подтверждённый ORCID iD, организация. Сделано, когда: читатель, пришедший с ORCID или с сайта, узнаёт автора.
- Создаём репозиторий с именем, совпадающим с именем пользователя, и кладём в него README о себе: области исследований, репозитории, ключевые публикации, ссылки на профили. Сделано, когда: на странице профиля вместо пустого места отображается текст.
- Создаём первый репозиторий работы: короткое латинское имя без косой черты, публичный доступ, лицензия Creative Commons. Сделано, когда: адрес в строке браузера совпадает с задуманным.
- Заполняем About: описание, сайт, темы. Сделано, когда: репозиторий находится поиском по платформе по ключевому слову из описания.
- Пишем README по пяти вопросам: что это, кто автор, о чём, из чего состоит, как цитировать. Сделано, когда: библиографическую запись можно скопировать из README в список литературы без правок.
- Добавляем обратные ссылки: адрес GitHub указываем на личном сайте и в профиле ORCID в поле «сайты». Сделано, когда: с профиля GitHub можно дойти до ORCID и обратно.
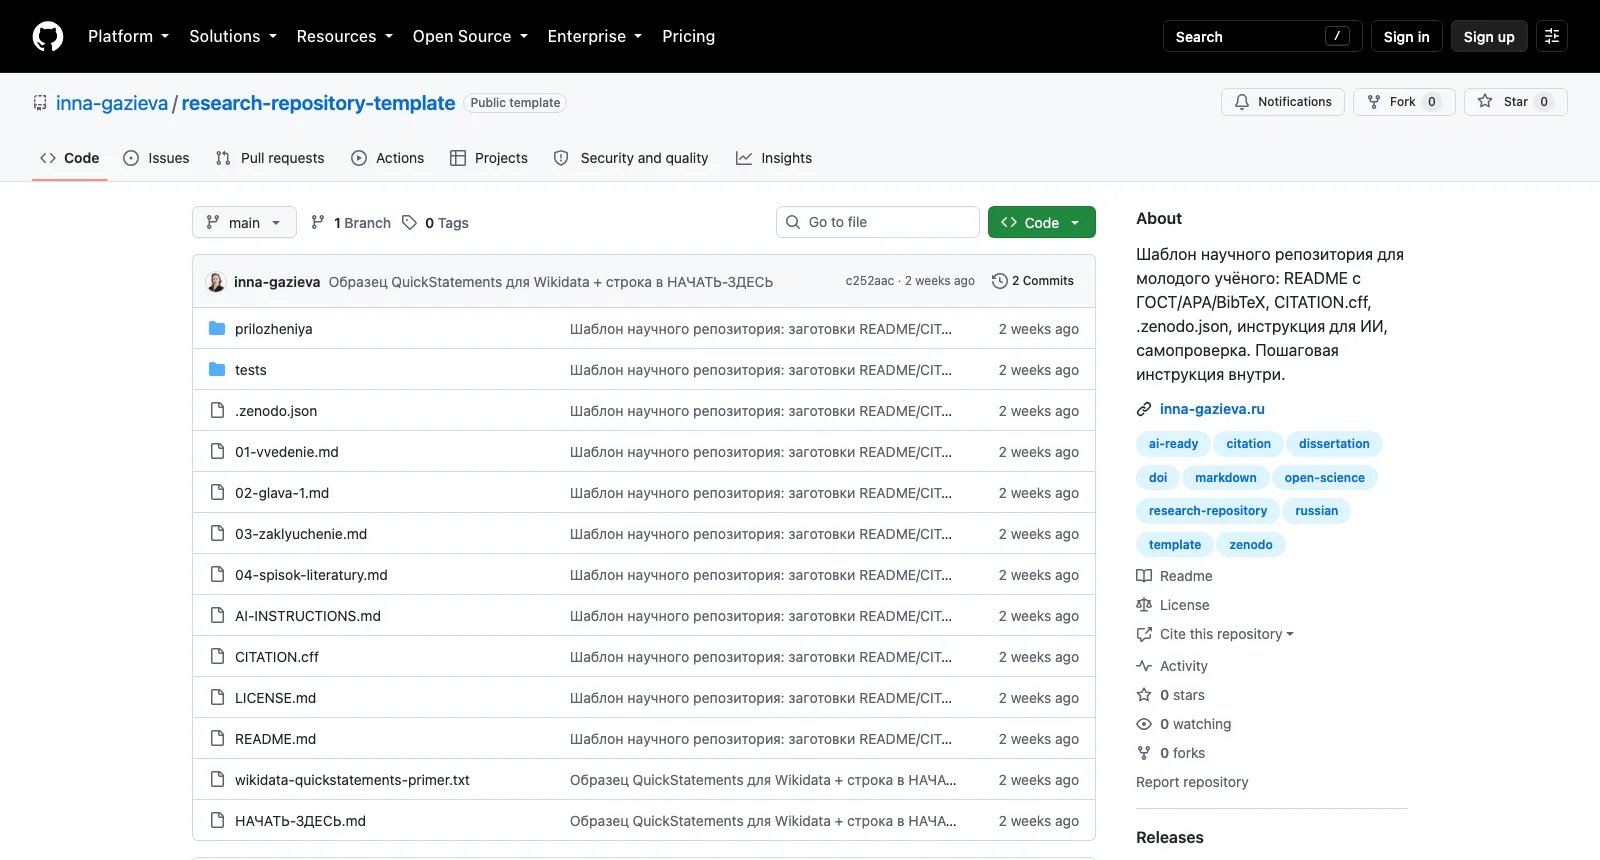
Чтобы не собирать всё это с нуля, я подготовила репозиторий-шаблон «научный репозиторий молодого учёного» с заполненными образцами README и служебных файлов: github.com/inna-gazieva/research-repository-template. Его можно скопировать одной кнопкой «Use this template» и заменить реквизиты на свои; пошаговая инструкция лежит внутри.
Вопросы и ответы
Нет. Для размещения научных текстов достаточно браузера: файлы загружаются перетаскиванием, правятся во встроенном редакторе, а каждое сохранение сопровождается коротким пояснением. Командная строка и программа Git понадобятся только тем, кто захочет работать с репозиторием с компьютера, и это необязательно.
На момент публикации бесплатный аккаунт позволяет создавать неограниченное число публичных и приватных репозиториев; для размещения текстов, таблиц и небольших наборов данных этого достаточно. Платные тарифы рассчитаны на команды разработчиков.
Давно существующую личную почту на крупном почтовом сервисе. Новый адрес на собственном домене или университетская почта могут быть приняты системой защиты за «временные», и аккаунт станет невидимым для читателей, как случилось со мной. Доменный адрес можно добавить в аккаунт вторым позже.
Скорее всего, аккаунт помечен системой защиты от злоупотреблений; владельцу при этом всё показывается как обычно. Нужно обратиться в поддержку через форму восстановления доступа, коротко описав, кто вы и зачем вам аккаунт. В моём случае причиной была почта, ответ пришёл через несколько часов, а документы не потребовались.
Аккаунт называется так, как фамилия автора пишется латиницей в публикациях: это публичный идентификатор, и менять его потом дорого. Репозиторий получает короткое латинское имя, из которого понятен тип работы: dissertation-…, paper-…, dataset-…. В поле имени вводится только имя, без имени пользователя и косой черты.
Для текстов приняты лицензии Creative Commons. CC BY разрешает любое использование с указанием автора; CC BY-NC-ND сохраняет текст неизменным и исключает коммерческое использование, что уместно для диссертации. Лицензию можно ставить только на тексты, права на которые принадлежат автору.
Издательский макет принадлежит издателю, выкладывать его без разрешения нельзя. Допустимость размещения авторской рукописи определяется политикой журнала. Собственная диссертация, доклады и авторские переводы принадлежат автору.
Это главный файл репозитория, который показывается на его странице. Для научной работы он отвечает на пять вопросов: что это за работа, кто автор, о чём она, из чего состоит и как её цитировать. Готовая библиографическая запись по ГОСТу обязательна.
Нет. Репозиторий делает сделанное видимым и проверяемым, но не является ни рецензированием, ни публикацией в смысле ВАК. Работа в репозитории дополняет журнальную публикацию, а не замещает её.
Через связку репозитория с научным архивом, который присваивает постоянный идентификатор бесплатно. Общая логика этой связки описана в обзорной статье о цифровом пространстве учёного.