Постоянный идентификатор публикации, DOI, из диковинки превратился в норму: его просят редакции, его требуют грантовые отчёты, по нему работу находят международные базы и ИИ-ассистенты. При этом у молодого учёного в России большинство работ идентификатора не имеет: материалы конференций, статьи в небольших журналах, тезисы докладов, диссертация выходят без DOI, и получить его «задним числом» через издателя невозможно.
Проблема исследователя в том, что работа без постоянного идентификатора почти невидима для международной инфраструктуры науки. Реестры и графы цитирования, от OpenAlex до профилей ORCID, собирают сведения о публикациях по DOI; статья, которой в этих реестрах нет, для зарубежного коллеги, агрегатора и ИИ-ассистента остаётся в лучшем случае случайной находкой, сколько бы её ни цитировали в русскоязычной среде. У меня, например, более полутора сотен публикаций, и лишь небольшая их часть имеет DOI, а значит, видна за пределами российских баз.
Решение при этом стало доступным: открытые архивы выпускают DOI бесплатно и без участия издателя, а цепочка сервисов, по которой идентификатор разлетается по базам, работает автоматически. Однако именно здесь молодого учёного подстерегают ошибки, о которых в инструкциях не пишут: релиз, оставшийся без идентификатора; два DOI у одной работы, и непонятно, какой ставить; работа, которую все базы видят, а Google Scholar не находит.
Что представляет собой DOI с точки зрения практики? По сути, это запись в реестре одного из регистрационных агентств, которая связывает короткий код вида 10.XXXX/… с постоянным адресом работы и её описанием. Агентств несколько: издательские DOI регистрирует Crossref, а DOI открытых архивов и данных чаще всего DataCite. Это различие кажется технической деталью, но именно оно объясняет половину описанных ниже странностей.
В обзорной статье «Цифровое пространство молодого учёного» я описала систему в целом. Здесь цель другая: пройти путь выпуска DOI по шагам на моём опыте с диссертацией и девятью английскими переводами статей, показать, какие решения приходится принимать на каждом шаге, что происходит с идентификатором после выпуска и как закрыть единственную серьёзную дыру этого пути, невидимость для Google Scholar.
Содержание
- Что можно опубликовать в Zenodo: работы, у которых нет другого пути
- Zenodo: порядок действий, который нельзя нарушать
- Два DOI у одной работы: какой куда ставить
- Связи между записями: зачем нужны related identifiers
- Что происходит с DOI само: DataCite, OpenAlex, OpenAIRE, ORCID
- Дыра Google Scholar и как её закрыть
- Три совета «не делать»
- Чек-лист: DOI выпущен правильно, когда
- Вопросы и ответы
Что можно опубликовать в Zenodo: работы, у которых нет другого пути
Прежде чем говорить о шагах, стоит назвать главное свойство архива, о котором инструкции обычно молчат. Журнал принимает статью, и только её. Всё остальное, что производит исследователь, легального способа публикации с идентификатором не имеет: презентация доклада с конференции, массив данных или таблицы распределений, набор скриптов для обработки, анкета, инфографика, постер, расширенные тезисы, препринт, полный текст диссертации. Выложить презентацию в открытый доступ, конечно, можно и без архива, на сайте или в облаке. Но у такого файла не будет ни DOI, ни записи в реестрах, ни библиографического описания, и сослаться на него коллега сможет разве что по адресу, который завтра изменится.
Zenodo принимает работы любого из этих типов и каждой выпускает полноценный идентификатор. Для меня это оказалось важнее, чем DOI для диссертации: доклад о наставничестве, прочитанный в Центре знаний «Машук», существовал только как файл презентации, а теперь у него есть DOI, запись с автором и датой и постоянный адрес, по которому его можно указать в списке работ. Так у части научной деятельности, которая раньше исчезала после конференции, появляется след, и для молодого учёного, у которого статей ещё немного, а докладов и данных уже достаточно, это и есть главная причина освоить архив.
Zenodo: порядок действий, который нельзя нарушать
Zenodo является открытым архивом, который создала и поддерживает Европейская организация ядерных исследований (ЦЕРН), та самая, где работает Большой адронный коллайдер; на момент публикации архив бесплатен для исследователей. Он принимает тексты, данные, презентации и программы, выпускает для каждой записи DOI через агентство DataCite и умеет забирать материалы прямо из репозитория на GitHub. Если репозиторий уже есть, а как его завести, я рассказывала в статье о GitHub для учёного, путь до идентификатора занимает один вечер. Порядок действий строгий, и я перечислю его именно в том порядке, в каком он должен выполняться.
Шаг первый: подготовить описание для архива до всего остального. В репозиторий кладётся файл .zenodo.json с типом работы, названием, автором с ORCID и аффилиацией, полной датой публикации в формате год-месяц-день, языком, лицензией, ключевыми словами на двух языках и связями с другими работами, о которых ниже. Архив читает этот файл в момент выпуска идентификатора; если файла нет, запись придётся заполнять руками, а если он появится позже, на уже выпущенную запись он не повлияет. Обращу внимание на дату: Zenodo требует полную дату, и для диссертации это дата защиты, для перевода дата его публикации, а не год оригинала.
Шаг второй: войти на zenodo.org через аккаунт GitHub и в настройках, в разделе GitHub, включить переключатель напротив нужного репозитория. С этого момента архив следит за репозиторием и ждёт релиза.
Шаг третий, и только теперь: создать на GitHub релиз, то есть зафиксированную версию репозитория с номером, например v1.0, и коротким описанием. Через несколько минут Zenodo забирает копию релиза, создаёт запись по описанию из файла и выпускает DOI.

Здесь и кроется главная ловушка: релиз создан раньше, чем включён переключатель. Архив о таком релизе не знает, и идентификатора у него не будет никогда. Задним числом это не лечится: единственный выход состоит в том, чтобы включить переключатель и выпустить следующий релиз, v1.0.1, который и получит DOI. Ничего страшного в этом нет, но первый релиз так и останется «пустым», и в истории репозитория это видно. Правило простое: сначала переключатель, потом релиз, и никогда наоборот.
Шаг четвёртый: сверить запись. После выпуска стоит открыть страницу записи в Zenodo и проверить тип работы, имя автора и ORCID, дату, лицензию и язык. Автор в архиве записывается латиницей в том виде, в каком он значится в ORCID и в международных базах: у меня это «Gazieva, Inna», без отчества, потому что так работу свяжут с остальными моими публикациями. Кириллическое написание сохраняется в описании и в README.
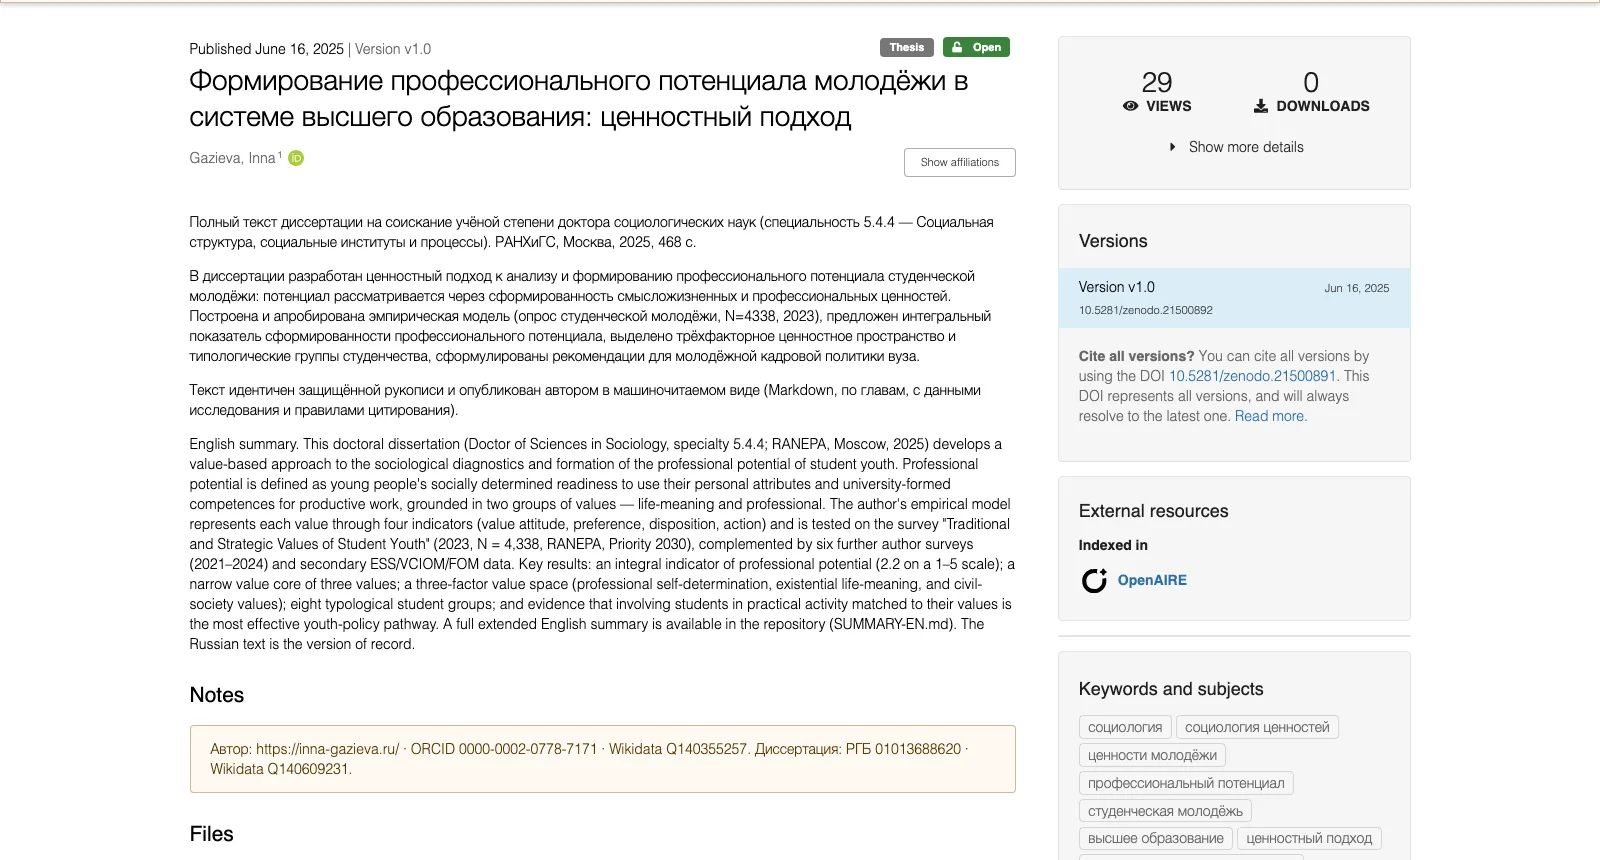
Шаг пятый: вернуть DOI в репозиторий. Идентификатор вписывается в README, в служебные файлы и в блоки «Как цитировать» каждого файла, и на этом первый круг замкнут. Какой из двух идентификаторов вписывать, обсудим отдельно, потому что их действительно два.
Два DOI у одной работы: какой куда ставить
Сразу после выпуска у записи оказывается два идентификатора, и это сбивает с толку каждого, кто проходит путь впервые. Первый называется DOI версии и указывает на конкретный зафиксированный вариант работы: у моей диссертации это 10.5281/zenodo.21500892. Второй называется DOI всех версий, или concept DOI, и указывает на работу как таковую, во всех её версиях, настоящих и будущих: у диссертации это 10.5281/zenodo.21500891. Номера соседние, и перепутать их легко.
Логика разделения такова. Если в тексте будет исправлена опечатка и выйдет версия 1.1, у неё появится собственный DOI версии, тогда как DOI всех версий останется прежним и будет вести на страницу, откуда видны все версии сразу. Тот, кто сослался на DOI всех версий, не потеряет ссылку никогда; тот, кто сослался на DOI версии, всегда попадёт именно на тот текст, который читал.
Отсюда правило, к которому я пришла после того, как однажды сделала наоборот и потом переписывала метаданные во всех репозиториях. В машиночитаемые файлы, то есть в CITATION.cff, в значок DOI в README и во внешние ссылки на работу, ставится DOI всех версий: он покрывает будущие версии и не устареет. В библиографической записи, которую читатель копирует в список литературы, допустимы оба, и выбор зависит от задачи: DOI версии, когда важна дословная точность цитируемого текста, DOI всех версий, когда речь о работе в целом. В карточке цитирования есть отдельное поле для предпочтительной ссылки, и там я указываю DOI версии, а в общих полях записи DOI всех версий.
Замечу, что ничего похожего у издательских DOI нет: журнальная статья имеет один идентификатор навсегда, и версий у неё не предполагается. Двойственность появляется именно потому, что архив хранит историю изменений, и для научного текста это скорее преимущество, чем неудобство.
Связи между записями: зачем нужны
Отдельного внимания заслуживает поле записи, которое многие оставляют пустым, а зря: связанные идентификаторы. В нём для работы указываются другие записи и отношение к ним. У моей диссертации это ссылка на запись в каталоге Российской государственной библиотеки и на элемент Wikidata как альтернативные идентификаторы той же работы, ссылка на монографию, из которой выросла диссертация, и на статью, написанную по её материалам, как на связанные публикации.
У английских переводов статей связи важнее всего, и в обзорной статье я назвала это принципиальным правилом: перевод не является новой публикацией. В записи перевода стоит отношение «является вариантом» с указанием DOI оригинальной русскоязычной статьи, и это отношение читают базы данных: они понимают, что перед ними та же работа на другом языке, а не удвоение списка публикаций. Там же указана ссылка на диссертацию, откуда взяты данные, и на другие переводы серии.
Зачем это нужно на практике? Три причины. Во-первых, честность: базы и читатели видят, что оригинал и перевод одно и то же, и не засчитывают автору две работы за одну. Во-вторых, навигация: со страницы перевода читатель попадает на оригинал, а из графа цитирований, который строят агрегаторы, видно, что цитируется одна работа. В-третьих, склейка сущности: чем больше проверяемых связей между записями об одном авторе и одной работе, тем увереннее поисковые системы и ассистенты считают их одним объектом, а не набором совпадений.
Связи задаются в том же файле .zenodo.json до выпуска идентификатора; для уже выпущенной записи их можно добавить через редактирование записи в архиве, и на DOI это не влияет.
Что происходит с DOI само: DataCite, OpenAlex, OpenAIRE, ORCID
Обратимся к тому, что многие недооценивают: после выпуска идентификатора начинается движение, в котором автор уже почти не участвует. Опишу его на своём примере.
Zenodo регистрирует DOI в агентстве DataCite, и с этого момента запись о работе доступна всем, кто читает реестр DataCite. Первым её забирает OpenAlex, открытый граф научных публикаций, на котором построены многие исследовательские ассистенты и агрегаторы: моя диссертация появилась в OpenAlex на следующий день после выпуска DOI, с обоими идентификаторами и привязкой к моему авторскому профилю, без единого действия с моей стороны. Затем работу забирает OpenAIRE, европейский агрегатор открытой науки: диссертация оказалась там в течение нескольких дней, с корректным заголовком, автором и отметкой открытого доступа. Обе площадки я проверяла по их открытым интерфейсам, и это доступно каждому: достаточно ввести свой DOI в поиск.
Отдельно стоит связка с ORCID. В настройках DataCite можно один раз включить автоматическое обновление профиля ORCID; после этого каждый новый DOI, выпущенный на имя автора с указанием его ORCID, сам появляется в списке работ профиля. Я включила это в июле, и с тех пор переводы статей прилетают в ORCID без ручного добавления. Подробнее о самом профиле ORCID и его роли в связке профилей я писала в статье о профилях молодого учёного.
Ради этого движения конвейер и затевается: международные графы видят только работы с DOI, зарегистрированным в Crossref или DataCite, и никакое заполнение профилей этого не изменит. Открытый архив с бесплатным DOI является для работы без издательского идентификатора единственной дверью в международную инфраструктуру, а связи между записями гарантируют, что войдёт она туда как та же самая работа, а не как безымянный дубль.
Дыра Google Scholar и как её закрыть
Теперь о единственной серьёзной неприятности этого пути, о которой я узнала не сразу. Google Scholar, одна из самых популярных у исследователей поисковых систем по научной литературе, записи Zenodo не индексирует. Это не сбой и не временная ситуация: об этом прямо сказано в разделе вопросов и ответов самого Zenodo, и причина в том, что архив принимает материалы любых типов, а Scholar собирает только то, что распознаёт как научные публикации по своим правилам разметки. Иными словами, работа с DOI, видимая в OpenAlex, OpenAIRE и ORCID, в Scholar не находится и в профиль автора сама не попадает.
Для русскоязычной работы это терпимо: её и так находят через eLibrary. Для английских переводов, которые и делались ради зарубежного читателя, невидимость в Scholar обесценивала бы половину усилий. Обход, к которому я пришла и который проверила на девяти переводах, состоит из двух частей.
Первая часть: дублирование перевода в архиве препринтов, который Scholar индексирует. Для социальных наук это SocArXiv, открытый архив на платформе OSF; на момент публикации он бесплатен. Каждому переводу там выдаётся собственный DOI вида 10.31235/osf.io/…, а в описании указываются реквизиты и DOI оригинала и Zenodo-запись, так что связь между копиями сохраняется. Записи SocArXiv Scholar забирает по обычному расписанию: на момент проверки в конце августа 2026 года все девять моих переводов, размещённых там в июле и августе, были видны в профиле Scholar, восемь из них именно как записи архива препринтов с пометкой «авторский английский перевод».
Вторая часть: решение о том, как переводы живут в профиле Scholar. Когда записи появились, у автора есть выбор: объединить каждую с русскоязычным оригиналом, чтобы работа занимала одну строку, или оставить переводы отдельными строками. Я выбрала второе, и объясню почему. Библиографически перевод остаётся версией одной работы: в его записи указана связь с оригиналом, и как самостоятельную статью я его нигде не заявляю. Но для читателя и для поисковых систем это отдельный объект со своим идентификатором, языком и аудиторией, и именно отдельная английская строка в профиле делает работу находимой для зарубежного коллеги, который ищет по английскому названию. Цена такого решения понятна: если перевод начнут цитировать, эти цитирования будут копиться отдельно от оригинала, и общий счётчик работы окажется разбит на две части. На момент публикации цитирований у переводов ещё нет, и я считаю видимость важнее консолидации метрик; если приоритет изменится, слияние в Scholar обратимо и выполняется кнопкой «Объединить» за минуту. Иной случай, когда слияние необходимо, я описывала в статье о профилях: там речь шла об англоязычных записях, которые создаёт сам журнал для той же публикации, и их объединение с русской версией прибавило шестнадцать цитирований, потому что это не перевод, а та же самая публикация в двух языковых карточках.
Оговорюсь о смежном сервисе. SSRN, архив препринтов по социальным наукам, принадлежащий издательству Elsevier, тоже принимает переводы и тоже виден в Scholar, но в его форме поле «DOI оригинала» проверяет идентификаторы только по реестру Crossref, и DOI, выпущенный через Zenodo, туда вписать не удаётся; связь с оригиналом приходится указывать текстом в описании. Это ровно то различие агентств, о котором я говорила в начале: технически оба идентификатора равноправны, но проверяют их разные реестры.
Три совета «не делать»
Сведу опыт в три предостережения.
Не выпускать новый DOI на каждую правку. Опечатка, уточнённая ссылка, поправленная подпись к таблице оформляются новой версией той же записи, а не новой записью. Новая запись нужна только для действительно новой работы.
Не размножать одну работу в несколько «публикаций». Диссертация в репозитории, её английское резюме и препринт перевода статьи связаны между собой отношениями в записях и правилом «цитировать оригинал» в README. Без этих связей три DOI на одну работу выглядят как накрутка публикационного списка, о вреде которой я писала в разборе профилей; со связями они читаются как одна работа в нескольких формах доступа.
Не полагаться на автоматику без проверки. Запись, пришедшая в OpenAlex или ORCID сама, стоит открыть и просмотреть: базы иногда путают однофамильцев, а автоматически созданный дубль автора в графе приходится сливать через поддержку сервиса. В моём случае в OpenAlex рядом с основным профилем возникли дубли, а среди работ оказалась чужая статья 2008 года по лингвокультуре с грязными метаданными; такое исправляется заявкой автора на самом сервисе, и делать это приходится руками.
Чек-лист: DOI выпущен правильно, когда
- Заполняем .zenodo.json до релиза: тип работы, автор латиницей с ORCID и аффилиацией, полная дата, язык, лицензия, ключевые слова на двух языках, связанные идентификаторы. Сделано, когда: файл валиден и лежит в репозитории.
- Включаем переключатель репозитория в настройках Zenodo. Сделано, когда: репозиторий помечен как отслеживаемый.
- Только после этого создаём релиз v1.0 на GitHub. Сделано, когда: через несколько минут в Zenodo появилась запись с DOI.
- Сверяем запись: тип, автор, ORCID, дата, лицензия, язык. Сделано, когда: расхождений с задуманным нет.
- Вписываем DOI всех версий в CITATION.cff, значок в README и внешние ссылки; DOI версии в предпочтительную ссылку. Сделано, когда: самопроверка репозитория не находит расхождений между файлами.
- Включаем автоматическое обновление ORCID в DataCite. Сделано, когда: работа появилась в списке работ ORCID без ручного добавления.
- Проверяем OpenAlex и OpenAIRE по DOI через неделю. Сделано, когда: работа найдена и привязана к верному профилю автора.
- Для англоязычных работ дублируем препринт на SocArXiv с реквизитами оригинала и следим, чтобы запись появилась в профиле Scholar; решение «отдельная строка или слияние с оригиналом» принимаем осознанно. Сделано, когда: работа находится в Scholar по английскому названию.
Заготовка .zenodo.json со всеми полями и порядок шагов есть в репозитории-шаблоне «научный репозиторий молодого учёного»: github.com/inna-gazieva/research-repository-template.
Вопросы и ответы
На момент публикации Zenodo бесплатен для исследователей: архив создан Европейской организацией ядерных исследований (ЦЕРН) и поддерживается европейскими программами открытой науки. Платить нужно только за DOI через коммерческие агентства или издателей.
Такой релиз идентификатора не получит, и исправить это задним числом нельзя. Включите переключатель в настройках Zenodo и выпустите следующий релиз, например v1.0.1; DOI получит он.
В машиночитаемые файлы и внешние ссылки ставится DOI всех версий, он не устареет. В библиографической записи допустимы оба: DOI версии, когда важна дословная точность цитируемого текста, DOI всех версий, когда речь о работе в целом.
Scholar не индексирует Zenodo, об этом сказано в справке самого архива. Для англоязычных работ обход состоит в дублировании препринта на SocArXiv, который Scholar индексирует; запись появится в профиле, а сливать её с оригиналом или оставить отдельной строкой решает автор.
Да, если один раз включить автоматическое обновление в настройках DataCite и указывать ORCID автора в описании записи. После этого каждый новый DOI попадает в профиль без ручного добавления.
Для издательского макета нет: права на него у издателя. Для авторской рукописи или авторского перевода да, при условии, что политика журнала это допускает, а в записи указана связь с оригиналом и правило «цитировать оригинал».
Выглядит, если между записями нет связей. Отношение «является вариантом» с DOI оригинала в записи и правило цитирования оригинала в README делают перевод формой доступа к той же работе, а не второй публикацией.
Нет. Исправление оформляется новой версией той же записи: у версии появится свой DOI, а DOI всех версий и все накопленные ссылки останутся прежними.
Это два регистрационных агентства DOI: Crossref регистрирует издательские идентификаторы, DataCite идентификаторы открытых архивов и данных. Технически они равноправны, но некоторые сервисы проверяют идентификаторы только по одному из реестров, откуда и берутся расхождения вроде поля DOI в форме SSRN.